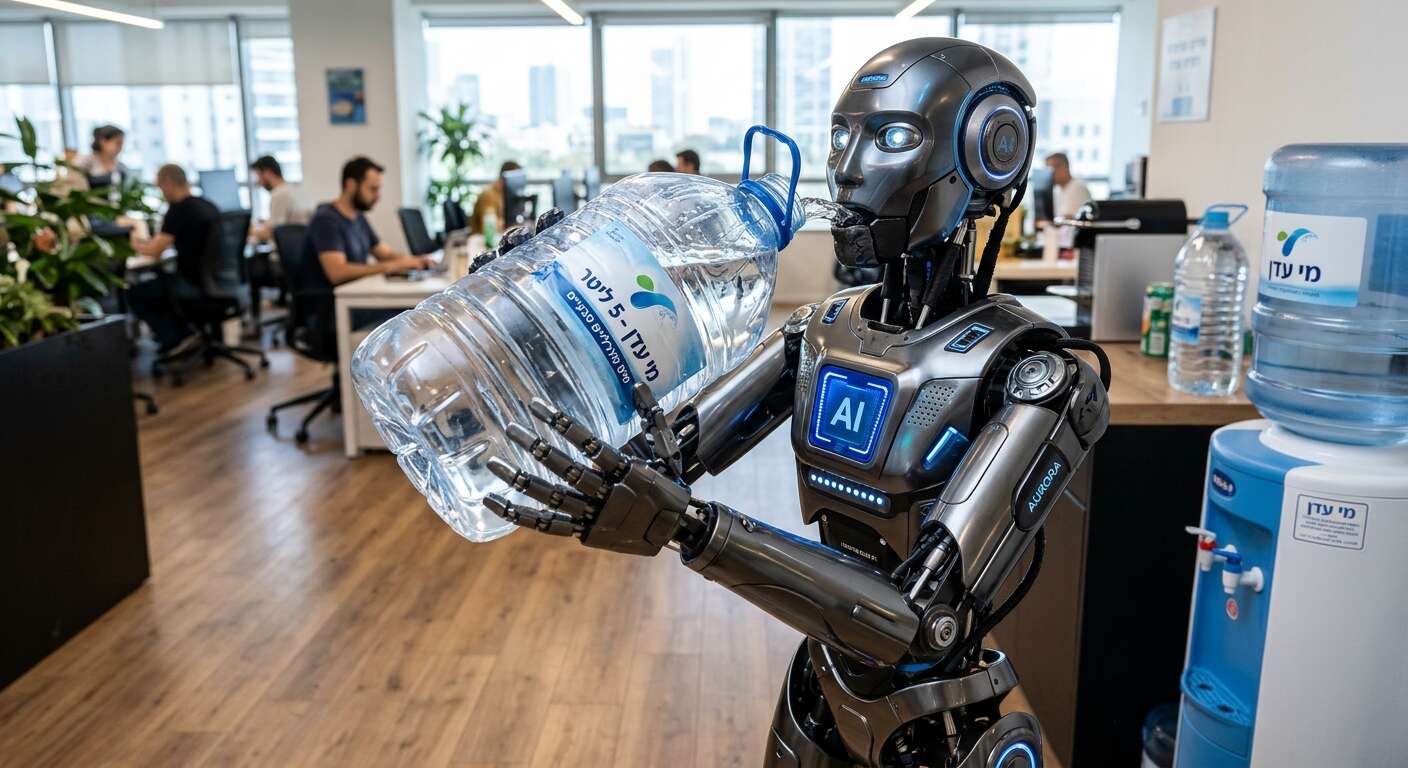

אנחנו רגילים לחשוב על בינה מלאכותית כמשהו שנמצא בענן, אבל מאחורי כל שאלה ל-ChatGPT, כל תמונה שנוצרת וכל סרטון שנבנה ב-AI, עומדים מרכזי נתונים ענקיים, מלאים בשבבים שעובדים ללא הפסקה.
והשבבים האלה מתחממים מאוד.
כדי לקרר אותם, מרכזי נתונים רבים משתמשים לא בעננים, אלא במים במצב הצבירה המוכר שלהם. בחלק מהמערכות המים מתאדים בתהליך הקירור, ולכן נחשבים למים שנצרכו – כלומר שבוזבזו. גם ייצור החשמל שמפעיל את השרתים עשוי לדרוש מים נוספים.
מחקר שהתבסס על מודל GPT-3 (זה שהשתמשנו בו אי אז ב-2022, בהשקת ChatGPT) העריך שכ-10 עד 50 תשובות בינוניות יכולות לצרוך כחצי ליטר מים בקירור של הרכיבים שעובדים בעיבוד שלהן.
אלא שמדובר במודל ישן, והטכנולוגיה משתפרת במהירות. גוגל, למשל, דיווחה ב-2025 שבקשת טקסט חציונית ל-Gemini צורכת כ-0.26 מ"ל מים בלבד – בערך חמש טיפות. גם מיקרוסופט מנסה לצמצם את הבעיה ובונה מרכזי נתונים חדשים שבהם מערכת הקירור אינה מאדה מים.
אלא שהפתרון יוצר בעיה אחרת: חשמל.
מרכזי הנתונים בעולם כבר אחראים לכ-180 מיליון טונות של פליטות פחמן דו-חמצני עקיפות בשנה כתוצאה מצריכת החשמל שלהם, והביקוש רק ממשיך לגדול עם התרחבות השימוש ב-AI. כלומר, הבעיה היא לא בהכרח השאלה הבודדת שאנחנו שולחים לצ'אט. הבעיה היא קנה המידה.
אנחנו בונים במהירות תעשייה שדורשת עוד מים, עוד חשמל, עוד שבבים ועוד חומרי גלם. ואם לא נדע להפוך אותה ליעילה ונקייה יותר, יכול להיות שנגלה שהבינה המלאכותית השמידה את העולם לא בדרך שבה סרטי מדע בידיוני הזהירה אותנו, אלא בזה שבשביל להפעיל אותה זיהמנו והרסנו את כל יתר העולם.
טעינו? נתקן! אם מצאתם טעות בכתבה, נשמח שתשתפו אותנו