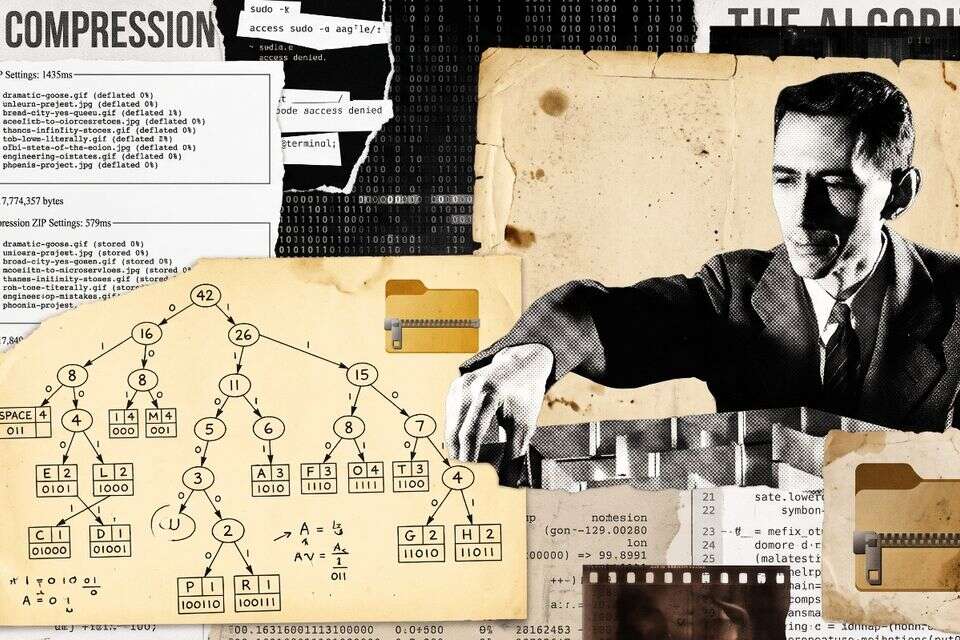
האנטומיה של המידע הנעלם: בכל יום מועברים ברחבי רשת האינטרנט העולמית מיליארדי קבצים דחוסים. בין אם מדובר בעדכון תוכנה כבד למערכת ההפעלה, מסמכי PDF הנשלחים בדואר אלקטרוני, או חבילות קוד ענקיות המועלות לענן - פעולת ה"ZIP" הפכה לחלק שגרתי ואינטואיטיבי מחיינו הדיגיטליים, עד שאיש כמעט אינו עוצר לתהות על פשר הפלא המתחולל מול עיניו.
דמיינו את הסיטואציה הבאה: יש לכם תיקיית מסמכים ששוקלת בדיוק גיגה-בייט אחד שלם. אתם לוחצים על מקש העכבר הימני, בוחרים בפקודה "דחוס", ותוך שניות ספורות נוצר קובץ ארכיון קטן שמשקלו 400 מגה-בייט בלבד. כאשר המקבל בצד השני לוחץ על הקובץ ומחלץ אותו, הוא מקבל חזרה את כל התיקייה המקורית - אותם אלפי מסמכים, שורות קוד, תווים ורווחים - במשקל המקורי של גיגה-בייט מלא, ללא שום שגיאה או פגם.
השאלה המתבקשת כמעט פילוסופית: היכן שהו אותם 600 מגה-בייט שנעלמו בזמן שהקובץ המתין על הדיסק?
האינטואיציה האנושית נוטה להשוות דחיסה דיגיטלית לפעולות בעולם הפיזי. כיווץ בגדים בתוך שקית ואקום באמצעות שאיבת האוויר, או מעיכה של פחית משקה ריקה. אולם בעולם המחשוב אין "אוויר" בין הקבצים, וביטים אינם עשויים ממתכת שניתן לקפל. ביט במחשב הוא ערך בינארי מוחלט - אפס או אחד. כיצד ניתן לקחת רצף של מיליארדי אפסים ואחדות, לחתוך ממנו יותר ממחצית מהאורך, ועדיין לשמור על היכולת לשחזר את הרצף המקורי בדיוק מושלם?
התשובה אינה נעוצה במחיקה של מידע, אלא באחת התובנות המבריקות ביותר בתולדות מדעי המחשב: חיסול הבזבוז של היתירות השפתית.
מדוע המחשב מבזבז שטח יקר?
כדי להבין כיצד פועלת דחיסה, יש להבין תחילה כיצד מחשבים מאחסנים טקסט באופן מסורתי. מעבדים דיגיטליים אינם מבינים מילים, אותיות או מושגים; הם מבינים אך ורק מתח חשמלי, המיוצג במתמטיקה בינארית כספרות 0 ו-1.
בראשית ימי המחשוב, בשנות ה-60 של המאה ה-20, נדרש תקן מוסכם שיקבע איזה מספר מייצג איזו אות. כך נולד תקן ASCII (ראשי תיבות של American Standard Code for Information Interchange). התקן קבע כלל ברזל פשוט - אורך קבוע לכל תו. כל אות באלפבית, כל ספרה וכל סימן פיסוק קיבלו "משבצת זיכרון" אחידה ונוקשה בגודל של 8 ביטים (בייט אחד).
בשיטה זוף האות A קיבלה את הרצף הבינארי 01000001 (המספר 65 בבסיס עשרוני). האות B קיבלה את הרצף 01000010 (המספר 66). האות N קיבלה את הרצף 01001110 (המספר 78). אפילו תו הרווח הפשוט ביותר מקבל 8 ביטים מלאים משלו.
היתרון בשיטת האורך הקבוע היה פשטות הנדסית. המחשב ידע שבכל פעם שעליו לקרוא אות, עליו לספור בדיוק שמונה צעדים קדימה. אולם מנקודת מבט של יעילות, מדובר בבזבוז אדיר. בשפות אנושיות, אותיות אינן מופיעות בתדירות שווה. באנגלית, למשל, האות E מופיעה בכ-12 אחוזים מכלל הטקסטים, בעוד האותיות Q או Z מופיעות בפחות משבריר האחוז. מדוע להקצות לאות הנפוצה ביותר בעולם את אותו נדל"ן דיגיטלי יקר המוקצה לאות נדירה שכמעט אינה בשימוש?
זה בדיוק כמו להדפיס ספר עב כרס שבו המילה "את" והמילה "אינציקלופדיה" מודפסות שתיהן על גבי שלט חוצות ענק באותו הגודל בדיוק.
מה זה קידוד באורך קבוע? שיטה לייצוג נתונים שבה כל סמל או אות מקבלים מספר זהה וקבוע מראש של ביטים, ללא תלות בתדירות הופעתם בטקסט. דמיינו חברת הובלות המחייבת את כל הלקוחות לשלוח חפצים אך ורק במכולות ענק של 40 מטר - גם אם אדם מעוניין לשלוח עט בודד, עליו לשלם על מכולת ענק שלמה.
שיעור הבננה
כדי להמחיש את גאונות הדחיסה בצורה הברורה ביותר, נשתמש בדוגמה אלגנטית ומזוקקת: המילה "בננה" (או באנגלית - BANANA). המילה מורכבת משש אותיות. בקידוד מחשב רגיל (ASCII), שבו כל אות נשמרת בשמונה ביטים, המילה תופסת בסך הכול 48 ביטים בזיכרון (6 כפול 8).
אך אם נביט בהרכב האותיות, נבחין מיד ביתירות מובהקת: האות A מופיעה שלוש פעמים (50 אחוזים מכלל המילה), האות N מופיעה פעמיים (33 אחוזים). האות B מופיעה פעם אחת בלבד (17 אחוזים). כאן מציע המדע רעיון מהפכני. הרעיון הזה הוא קידוד באורך משתנה. במקום לחלק לכל אות 8 ביטים, נעניק לאותיות הנפוצות ביותר קודים קצרים במיוחד, בעוד אותיות נדירות יקבלו קודים ארוכים מעט יותר.
מה זה קידוד באורך משתנה? שיטת ייצוג נתונים שבה מספר הביטים המוקצה לכל תו נקבע לפי שכיחותו: תווים נפוצים מקבלים מעט ביטים, ותווים נדירים מקבלים יותר ביטים. דמיינו ספר טלפונים של עיר שבו מספרי הטלפון של אנשי המוקד העירוני מורכבים משתי ספרות בלבד (כמו 106), בעוד מספרים של תושבים פרטיים מורכבים משבע ספרות מלאות.
נבחן את הקצאת הקודים: לאות הנפוצה ביותר, A, נקצה ביט בודד אחד בלבד: 0. לאות הבאה בתור, B, נקצה שני ביטים: 10. לאות N, נקצה שני ביטים: 11. כעת נרכיב מחדש את המילה BANANA באמצעות הקודים החדשים: האות B מוחלפת ברצף: 10. האות A מוחלפת ברצף: 0. האות N מוחלפת ברצף: 11. האות A מוחלפת ברצף: 0. האות N מוחלפת ברצף: 11. האות A מוחלפת ברצף: 0.
התוצאה המתקבלת היא מחרוזת בינארית רציפה בת תשעה ביטים בלבד: 100110110.
המשמעות המספרית היא שהמידע המקורי שדרש 48 ביטים מכווץ כעת ל-9 ביטים בלבד - חיסכון בלתי נתפס של מעל 81 אחוזים בנפח האחסון. ואף לא פרט אחד של מידע נמחק או אבד בתהליך.
האלגוריתם של הופמן
כאן עולה השאלה מי קובע אילו אותיות יקבלו קודים קצרים ואילו יקבלו קודים ארוכים? כיצד מחשב יודע לייצר באופן מתמטי את הקוד הקצר ביותר האפשרי עבור כל קובץ נתון? הפתרון נקרא קידוד הופמן. אלגוריתם מבריק שהומצא בשנת 1951 על ידי דייוויד הופמן בעת שהיה סטודנט לתואר שני במכון הטכנולוגי של מסצ'וסטס (MIT).
האלגוריתם פועל בשיטה ייחודית של "בנייה מלמטה למעלה" באמצעות מבנה נתונים הנקרא עץ בינארי. בשלב ראשון קורית ספירת שכיחויות. המערכת סורקת את הקובץ כולו וסופרת כמה פעמים מופיע כל תו. בדוגמת הבננה: B מופיע 1, N מופיע 2, ו-A מופיע 3. בשלב השני, מתרחש חיבור שתי השכיחויות הנמוכות ביותר. כלומר, האלגוריתם מאתר את שני התווים הנדירים ביותר - במקרה זה B ו-N. הוא מחבר אותם יחד תחת "צומת אב" משותף, ורושם מעליו את סכום שכיחותם: אחד ועוד שתיים שווה שלוש.
בשלב השלישי ישנה חזרה מעגלית. כעת ישנן שתי ישויות שוות ערך - האות A (שכיחות 3), והצומת המשותף של B ו-N (שכיחות 3). האלגוריתם מחבר את שתיהן לצומת עליון אחד - שורש העץ - שערכו שש (שלוש ועוד שלוש). בשלב הרביעי קורית חלוקת הביטים. כאן מסמנים את ענפי העץ. כל פנייה שמאלה בענף מסומנת בספרה 0, וכל פנייה ימינה מסומנת בספרה 1.
מה זה העץ הבינארי של הופמן? מבנה נתונים היררכי דמוי ענפי עץ הפוכים, שבו השורש נמצא למעלה והעלים (האותיות) למטה, המשמש לתרגום תווים למחרוזות של אפסים ואחדות על פי נתיב ההליכה בענפים. דמיינו מערכת שבילים ביער שבה בכל צומת דרכים ישנו שלט: ימינה זה 1 ושמאלה זה 0; הנתיב המדויק שאתם צועדים בו מהכניסה ליער ועד לבקתה של אות ספציפית הוא קוד הזיהוי שלה.
כדי לדעת מהו הקוד של כל אות, פשוט צועדים מראש העץ מטה לעבר האות. כדי להגיע ל-A: צועדים צעד אחד שמאלה > הקוד הוא 0. כדי להגיע ל-B: צועדים צעד אחד ימינה (1), ואז צעד אחד שמאלה (0) > הקוד הוא 10. כדי להגיע ל-N: צועדים צעד אחד ימינה (1), ושוב צעד אחד ימינה (1) > הקוד הוא 11.
היופי המתמטי באלגוריתם של הופמן הוא שהוא מוכח מתמטית כאלגוריתם האופטימלי ביותר שקיים לדחיסה מבוססת תווים בודדים. אין שום דרך בעולם לייצג את האותיות הללו בפחות ביטים מבלי לאבד מידע.
מדוע קוד הופמן לעולם לא מתבלבל?
כאשר מביטים במחרוזת הדחוסה 100110110, מתעוררת מיד בעיה הנדסית קשה. כיצד תוכנת החילוץ יודעת היכן מסתיימת אות אחת ומתחילה האות הבאה? בטקסט רגיל יש לנו רווחים בין מילים ופסיקים בין משפטים. אך בזרם ביטים של מחשב אין פסיקים ואין מרווחים; יש רק רצף אינסופי של אפסים ואחדות. האם המחשב לא עלול לחשוב בטעות ששני הביטים הראשונים (10) הם שתי אותיות A רצופות (0 ו-0)? או אולי מדובר באות אחרת לגמרי? כאן נכנס לתוקף המאפיין הקריטי ביותר של קידוד הופמן: היותו קוד ללא תחיליות.
מה זה קוד ללא תחיליות? שיטת קידוד שבה שום קוד בינארי של אות מסוימת אינו מהווה את החלק ההתחלתי של קוד של אות אחרת. דמיינו מערכת שבה קידומת הטלפון של עיר מסוימת היא 03; לפי עיקרון זה, לעולם לא תותר פתיחת קידומת חדשה בשם 035, מכיוון שהמרכזייה תחייג מיד לעיר הראשונה ברגע שתשמע את הספרות 03 ותתבלבל.
אם נקבע שהקוד 110 מייצג את האות F, לעולם לא נוכל לאפשר שום קוד בעולם שמתחיל ברצף 110 (כגון 1100 או 1101). אם היה קיים קוד 1100, המפענח היה קורא את שלושת הביטים הראשונים (110), עוצר ומשוכנע שמדובר ב-F, ולא יודע מה לעשות עם האפס המיותם שנשאר. בזכות מבנה העץ הבינארי, כל האותיות ממוקמות אך ורק בקצות הענפים - ב"עלים" - ולעולם לא בתוך צמתי הביניים של העץ. כתוצאה מכך, תהליך הפענוח הוא פשוט וחד-משמעי לחלוטין.
המחשב קורא את הביט הראשון: 1. האם יש אות שמוגדרת כ-1? לא. הוא קורא את הביט הבא: 0. הרצף הוא 10. האם יש אות שמוגדרת כ-10? כן, זוהי האות B. המחשב פולט את האות B, מאפס את המצביע וחוזר לראש העץ. לאחר מכן הוא קורא את הביט הבא: 0. האם 0 הוא אות? כן, זוהי האות A. בהמשך, המחשב פולט A, ושוב חוזר לראש העץ. בצורה זו, המחשב קורא את זרם הביטים באופן רציף, חלק ומדויק, ללא צורך בשום תווי הפרדה וללא שום סיכון לפענוח שגוי.
כיצד באמת פועל קובץ ZIP שלם?
דוגמת ה"בננה" מסבירה בצורה מופתית את אופן הפעולה של קידוד הופמן. אולם משתמש חד עין עשוי להקשות. הרי קובץ ה-ZIP חייב לשמור בתוך עצמו גם את "טבלת התרגום" (עץ הופמן) כדי שתוכנת החילוץ תדע כיצד לפענח את הביטים בצד השני. אם נשמור את הטבלה יחד עם 9 הביטים, הטבלה עצמה תתפוס מקום נוסף. אז כיצד אם כן מצליח קובץ ZIP אמיתי לכווץ תיקייה מ-1 גיגה-בייט ל-400 מגה-בייט?
התשובה היא שפורמט ZIP המודרני אינו משתמש בקידוד הופמן לבדו. הוא משתמש באלגוריתם משולב רב-עוצמה הנקרא DEFLATE, אשר פותח בשנת 1989 על ידי המתכנת האגדי פיל כץ (Phil Katz), מייסד תוכנת PKZIP. אלגוריתם DEFLATE פועל בשני שלבים עוקבים ומתוחכמים.
שלב א' הוא חיסול מילים כפולות (אלגוריתם LZ77). לפני שתוכנת ה-ZIP בכלל מסתכלת על אותיות בודדות, היא מפעילה אלגוריתם שנולד בישראל בשנת 1977 על ידי פרופסור אברהם למפל ופרופסור יעקב זיו מהטכניון - אלגוריתם LZ77.
אלגוריתם זה אינו מחפש תווים בודדים, אלא ביטויים, מילים ומשפטים שלמים שחוזרים על עצמם. דמיינו מסמך משפטי שבו הביטוי "מדינת ישראל" מופיע 500 פעמים לאורך החוזה. בפעם הראשונה שהביטוי מופיע, האלגוריתם רושם אותו כרגיל. אך בכל 499 הפעמים הבאות, המחשב אינו שומר את המילים "מדינת ישראל"; הוא פשוט רושם "מצביע לאחור" קצרצר שאומר: "חזור 120 תווים לאחור, והעתק משם 12 תווים".
המצביע הזה תופס שבריר מגודל המילים המקוריות. תהליך זה מנקה את כל החזרות הגדולות והמשפטים הדומים המצויים בקובצי טקסט, קוד, דוחות ומסדי נתונים.
שלב ב' הוא דחיסת המצביעים באמצעות קוד הופמן. רק לאחר שאלגוריתם LZ77 החליף את כל הטקסט החוזר במצביעים מתמטיים קצרים, נכנס לפעולה השלב השני: קידוד הופמן. הופמן לוקח את כל התווים שנותרו ואת כל המצביעים שיצר שלב א', סופר את שכיחותם, בונה עבורם עץ בינארי מושלם, וממיר את כולם לקודים קצרים באורך משתנה.
השילוב הקטלני הזה - מחיקת חזרות מילוניות של למפל-זיו, ואחריה דחיסה סטטיסטית של הופמן - הוא שמאפשר לקבצי ZIP, לפורמט התמונות PNG, ולפרוטוקול הגלישה של אתרי אינטרנט (Gzip) לצמצם מאות מגה-בייטים של מידע לכדי חבילה קומפקטית וקלת משקל.
3 דברים שחייבים להבין
1. מידע אינו נעלם - הוא מאורגן מחדש בצורה חכמה יותר: 600 המגה-בייט שנעלמו מקובץ ה-ZIP שלכם לא הושמדו ולא נמחקו. הם היו בסך הכול "שומן בינארי" - חזרות מיותרות, רווחים ריקים וקודים ארוכים מדי ששימשו את המחשב מטעמי נוחות. פעולת הדחיסה פשוט "מתרגמת" את המידע לשפה חסכונית בהרבה, ופעולת החילוץ מתרגמת אותו חזרה לשפה הרחבה.
2. אי אפשר לדחוס קובץ מכווץ שוב ושוב עד אינסוף: רבים תוהים אם הצלחנו לכווץ 1 גיגה ל-400 מגה-בייט, למה שלא נפעיל ZIP על קובץ ה-ZIP החדש ונכווץ אותו ל-100 מגה-בייט, ואז ל-10 מגה-בייט? הסיבה לכך היא חוק טבע מתמטי שנוסח על ידי קלוד שאנון (אבי תורת האינפורמציה), הנקרא "אנטרופיה של מידע". ברגע שקובץ עבר דחיסה, כל היתירות שבו חוסלה והוא נראה מבחינה סטטיסטית כמו רצף אקראי לחלוטין של ביטים. ברצף אקראי שבו כל האותיות מופיעות באותה שכיחות בדיוק, שום אלגוריתם דחיסה אינו מסוגל לחסוך אפילו ביט בודד נוסף.
3. סלסילת הקניות בסופרמרקט: דמיינו שאתם קונים בסופרמרקט 20 קופסאות קורנפלקס ענקיות העשויות מקרטון נפוח. הקופסאות ממלאות את כל תא המטען של הרכב שלכם (1 גיגה-בייט). אם תפתחו את הקופסאות, תוציאו את שקיות הדגנים הדחוסות ותקפלו את הקרטונים השטוחים בצד, כל הקניות יתפסו פחות מחצי מתא המטען (400 מגה-בייט). שום גרגר קורנפלקס לא אבד בדרך; פשוט הוצאתם את כל הנפח הריק והמיותר.
עבודת הסמסטר ששווה מיליארדים
אחד הסיפורים המרתקים והמעוררים השראה ביותר בהיסטוריה של המדע התרחש באביב של שנת 1951 במסדרונות המכון הטכנולוגי של מסצ'וסטס (MIT). דייוויד הופמן היה אז דוקטורנט צעיר בהנדסת חשמל, שלמד בקורס מתקדם בתורת האינפורמציה שהעביר פרופסור רוברט פאנו. באותה עת, הבעיה של מציאת הקוד הבינארי היעיל והקצר ביותר האפשרי נחשבה לאחת השאלות הפתוחות והקשות ביותר בעולם המדע הצעיר. אפילו קלוד שאנון עצמו, יחד עם פאנו, הצליחו לפתח רק אלגוריתם מקורב (קוד שאנון-פאנו), אך איש בעולם לא הצליח להוכיח כיצד ניתן לייצר את הקוד האופטימלי והמושלם ביותר.
לקראת סיום הסמסטר, פרופסור פאנו הציב בפני הסטודנטים שלו בחירה בלתי שגרתית: הם יכלו לגשת למבחן גמר סופי ומפרך, או לחילופין - להגיש עבודת סמסטר שתנסה למצוא פתרון מתמטי לבעיית הקוד הבינארי המושלם.
הופמן בחר באפשרות השנייה, והחל לעבוד במרץ. במשך חודשים ארוכים הוא ניסה כל גישה מתמטית אפשרית, מילא מאות דפי טיוטה בחישובים מסובכים, אך נכשל שוב ושוב. ככל שמועד ההגשה התקרב, הופמן הבין שהוא אינו מסוגל לפתור את הבעיה. בתסכול עמוק, הוא החליט לוותר, להשלים עם כישלונו, ואסף את כל דפי החישובים שלו כדי להשליך אותם לפח האשפה ולגשת למבחן הגמר.
אך בדיוק ברגע שבו עמד ליד פח האשפה, הכתה בו ההברקה: עד אותה עת, כל המדענים הגדולים - כולל שאנון ופאנו - ניסו לבנות את הקוד מלמעלה למטה, כלומר לחלק את כל האותיות לחצי, ואז לחצי נוסף. הופמן שאל את עצמו מה יקרה אם נהפוך את הכיוון ונבנה את הקוד מלמטה למעלה? מה אם נתחיל דווקא בשני הסמלים הנדירים ביותר, נחבר אותם, ונטפס בהדרגה אל השורש?
בתוך כמה שעות של עבודה לילית קדחתנית, הופמן פיתח את האלגוריתם המושלם והוכיח מתמטית את יעילותו הבלתי מנוצחת. עבודת הסמסטר שהגיש לפרופסור פאנו לא רק שהעניקה לו ציון מושלם, אלא הפכה לאחד המאמרים המצוטטים ביותר בתולדות מדעי המחשב ("A Method for the Construction of Minimum-Redundancy Codes", 1952).
שבעים שנה מאוחר יותר, האלגוריתם שהגה הסטודנט המתוסכל ברגע של ייאוש עומד מאחורי כל הורדת קובץ, כל תמונת אינטרנט וכל חבילת נתונים הנעה בעולם הדיגיטלי.
הניצחון השקט של האלגנטיות המתמטית
השאלה "לאן נעלמים 600 מגה-בייט כשמכווצים קובץ ZIP" חושפת את אחד ההישגים האינטלקטואליים המרשימים ביותר של הציוויליזציה המודרנית. היא ממחישה כיצד המחשב, שנתפס לעיתים קרובות כמכונה מכנית קרה ועיוורת, מסוגל להפעיל גמישות מתמטית מעודנת כדי להתאים את עצמו לחוקי השפה האנושית.
המידע אינו נעלם, אינו מתכלה ואינו נדחס בכוח זרוע. הוא פשוט מנוקה מכל המלל המיותר, מיוצג בעזרת עץ הופמן מבריק ללא תחיליות סוררות, וממתין בסבלנות עד לרגע שבו המשתמש יבקש לקרוא אותו מחדש.
בפעם הבאה שתשלחו קובץ ZIP ותראו את פס ההתקדמות רץ במהירות על המסך, זכרו את שיעור הבננה: היכולת לחסוך מקום, זמן ואנרגיה אינה דורשת קסמים ואינה מצריכה ויתור על פרטים - כל שנדרש הוא אלגוריתם חכם שיודע להבחין בין עיקר לטפל, ולהפוך את השפע המילולי לשיר קצר ומדויק של אפסים ואחדות.
טעינו? נתקן! אם מצאתם טעות בכתבה, נשמח שתשתפו אותנו