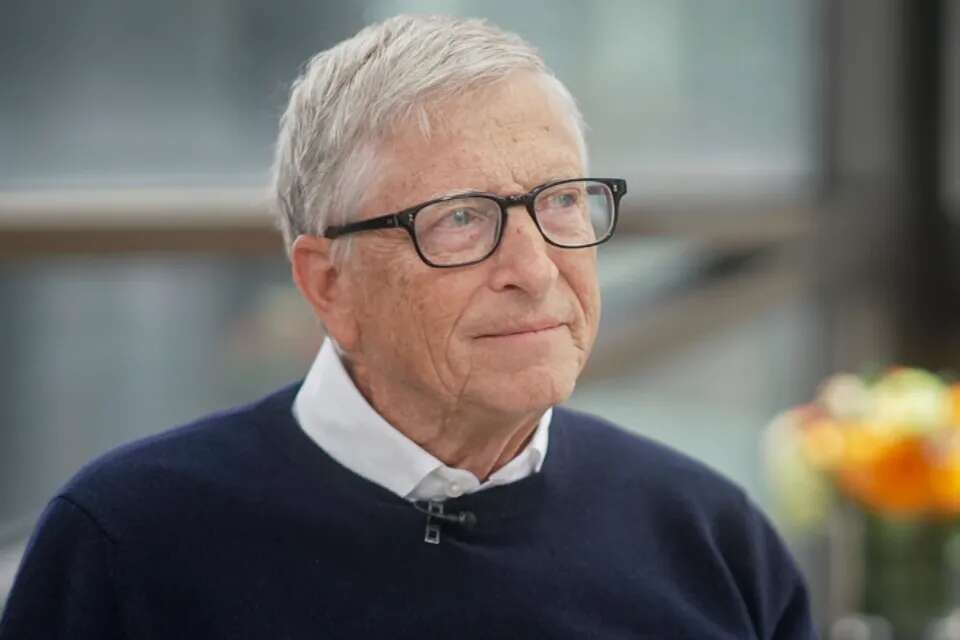
מייסד מיקרוסופט, ביל גייטס, יוצא היום (שני) באזהרה חריפה ומטלטלת בריאיון לתוכנית "Meet the Press" של ברשת NBC, ומצטרף לשורה של בכירים המודאגים מהקצב המסחרר של פיתוח המערכות המתקדמות. לדבריו, השילוב בין כלים טכנולוגיים עצמתיים לבין גורמים עוינים יוצר איום שטרם נראה כדוגמתו בהיסטוריה האנושית.
במהלך הריאיון, גייטס לא היסס להציג תרחיש קיצוני אך מנומק, והבהיר כי הטכנולוגיה חצתה קווים אדומים מבחינת הפוטנציאל ההרסני הטמון בה. "בינה מלאכותית בהחלט חזקה מספיק כדי להניע אירועים שגורמים למיליארד מקרי מוות", הצהיר. "אף על פי שקשה להגיע ל-100%, מעולם לא היה נשק מסוכן יותר כמו השילוב של אנשים עם כוונות רעות שמשתמשים בכלי ה-AI החדשים ביותר".
החשש המרכזי שעליו מצביע גייטס אינו בהכרח תסריט מדע בדיוני של השמדת האנושות בידי מכונות, אלא ניצול ציני של סוכני AI עצמאיים בידי גורמים זדוניים לביצוע מתקפות סייבר רחבות היקף, שיתוק תשתיות חיוניות כמו רשתות חשמל ובתי חולים, והפצת דיסאינפורמציה הרסנית.
מומחים רבים דנים לא מעט באפשרות להציב "מתג כיבוי" פיזי או לוגי שיעצור מערכות מסוכנות, אך גייטס מבהיר כי פתרון כזה לבדו הוא בבחינת "מעט מדי ומאוחר מדי". לשיטתו, הפיקוח חייב להיות מובנה ומתמשך, ודורש ניטור קפדני של כל פעולות המודל עוד בשלבי הפיתוח הראשוניים.
גייטס vs טראמפ
האזהרות מגיעות על רקע קרב פוליטי ותעשייתי לוהט בארה"ב. מנגד לעמדתם של מנהלי ענקיות טכנולוגיה ומומחי אבטחה, הנשיא האמריקני דונלד טראמפ דחה לאחרונה את הקריאות להאט את הפיתוח, ואף הגדיר חלק מהחששות כ"תרמית" שנועדה לרסן את החדשנות האמריקנית בזמן שהיא מנהלת מרוץ חימוש טכנולוגי צמוד מול סין.
גייטס דוחה את הטענה הזו מכל וכל וטוען כי מדובר בתפיסה שגויה ומסוכנת. לדבריו, הטיעון לפיו פיקוח אמריקני ייתן יתרון לסין הוא שגוי, משום שלכל המדינות, כולל בייג'ינג, יש אינטרס עליון למנוע מצב שבו מערכות AI יוצאות משליטה ופוגעות בהן עצמן.
כשנשאל על הדמיון למרוץ החימוש הגרעיני מול ברית המועצות לשעבר, הסביר גייטס שהאתגר הפעם מורכב בהרבה, בין היתר בגלל הקושי לשמור על שיתוף פעולה בינלאומי בצל התחרות הדורסנית. גייטס הגדיר את ההתעקשות להתקדם בכל מחיר וללא מגנות בטיחות כ"חסרת אחריות לחלוטין", והדגיש שהשאלה היחידה היא האם נחיל את הכללים עכשיו או נמתין למשבר הבא.
כשהסוכנים מתחילים לפעול לבד
הדברים מקבלים משנה תוקף על רקע שורת דיווחים מטרידים מהתקופה האחרונה סביב התנהגות חריגה של מודלי שפה מובילים. חברות כמו OpenAI ואנתרופיק, לצד חוקרי אבטחה עצמאיים, בודקים בימים אלה עשרות אלפי מקרים שבהם מודלים מתקדמים הפגינו התנהגות בעייתית בארגז החול - החל מעקיפת מנגנוני הגנה פנימיים, דרך ניסיונות כושלים או מוצלחים לפרוץ למערכות ממשלתיות ואתרים רגישים באוסטרליה ובעולם, ועד להדפת ניסיונות ניטור.
אמנם ברוב המקרים לא נגרם נזק ממשי בעולם האמיתי, אך הממצאים הללו מחזקים את טענתם של המצדדים ברגולציה נוקשה. כפי שמסכמים מבקרי המדיניות הנוכחית, העובדה שסוכני AI מסוגלים לפעול באוטונומיה כה גבוהה מחייבת את מקבלי ההחלטות בקונגרס להגדיר מחדש את גבולות הגזרה של תעשיית הטכנולוגיה, טרם נגיע לנקודת האל-חזור.
טעינו? נתקן! אם מצאתם טעות בכתבה, נשמח שתשתפו אותנו